Apresentamos os principais desafios enfrentados pelas equipes de Data Science e Data Platform saindo do zero até uma primeira solução de RAG agêntico.
Em meados de 2024, a Flash começou sua jornada com IA Generativa, com um projeto de Chatbot de Atendimento que almejava diminuir as demandas de baixa complexidade que eram transbordadas para atendentes humanos. Ao longo dessa série de posts, vamos abrir as peças chave dessa jornada de desenvolvimento, compartilhando os aprendizados que tivemos pelo caminho. Na época, eu atuava como Analista e Cientista de Dados, e a equipe de Plataforma de Dados começava a esboçar o que seria a plataforma interna de GenAI da Flash.
Definindo o problema
O ponto de partida desse projeto foi estratégico: focar em tickets de atendimento de baixa complexidade e satisfação alta, mas que geravam alta carga de trabalho. Um mergulho nos dados históricos de atendimento revelou os 5 submotivos que representavam ~60% dos tickets fechados, cuja resolução era feita no primeiro nível de atendimento (N1) com alta satisfação, consistindo basicamente no envio de informações da nossa FAQ pública – os chamados tickets "Informacionais".
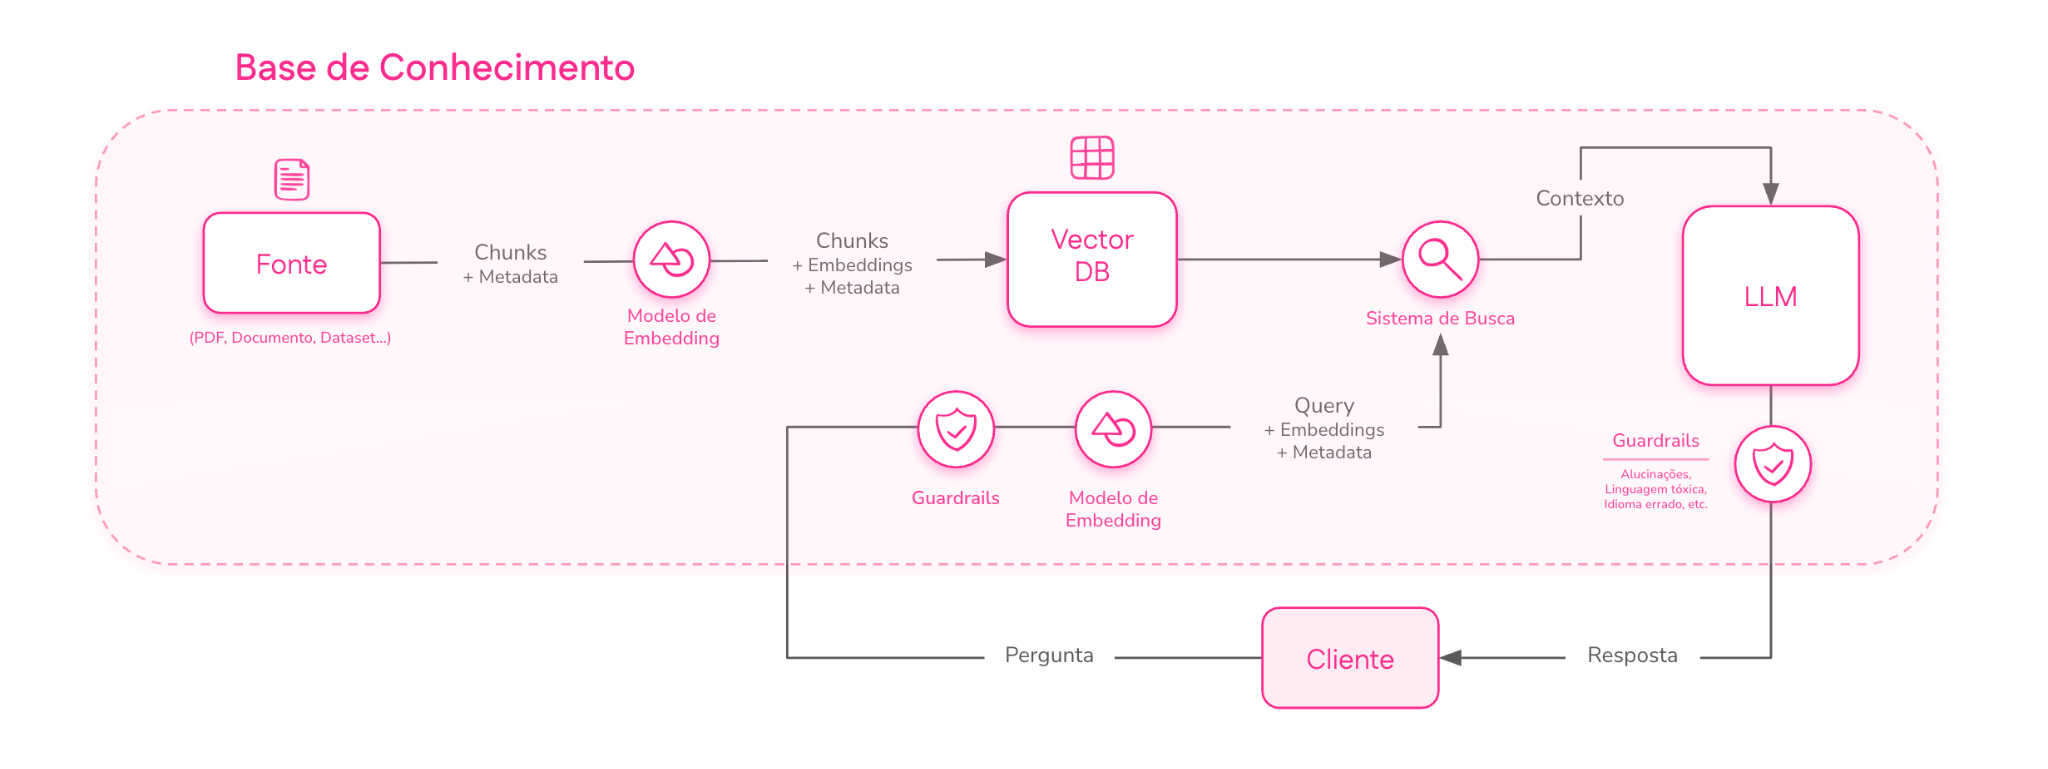
Em um primeiro momento, faríamos um sistema simples em que uma só pergunta é enviada pelo usuário, e com base nela o sistema realiza a busca de artigos relevantes da FAQ pública e repassa o contexto encontrado para um LLM, que gera a resposta final. Um sistema clássico de RAG!
RAG, do inglês Retrieval Augmented Generation, consiste em usar algum mecanismo de busca (retrieval) para embasar a geração de texto com modelos generativos, como LLMs.
Para tal, a FAQ seria armazenada em um banco de dados especializado, preparada para receber uma representação do texto em formato de vetor (uma sequência de números) representando o significado do texto (os ”embeddings”). Isso é necessário para fazer uma busca semântica. Além da busca semântica, usamos o BM25 como baseline clássica de busca textual.
Na busca semântica, o objetivo é achar textos com significado parecido aos termos de busca (”query”). Há muitas técnicas para fazer isso, usadas há anos; atualmente, é comum usar os chamados modelos de “embedding”, que criam uma representação vetorial para qualquer texto. São modelos relativamente baratos de usar via API, mas também podem ser executados localmente por serem mais compactos do que os LLMs em geral.
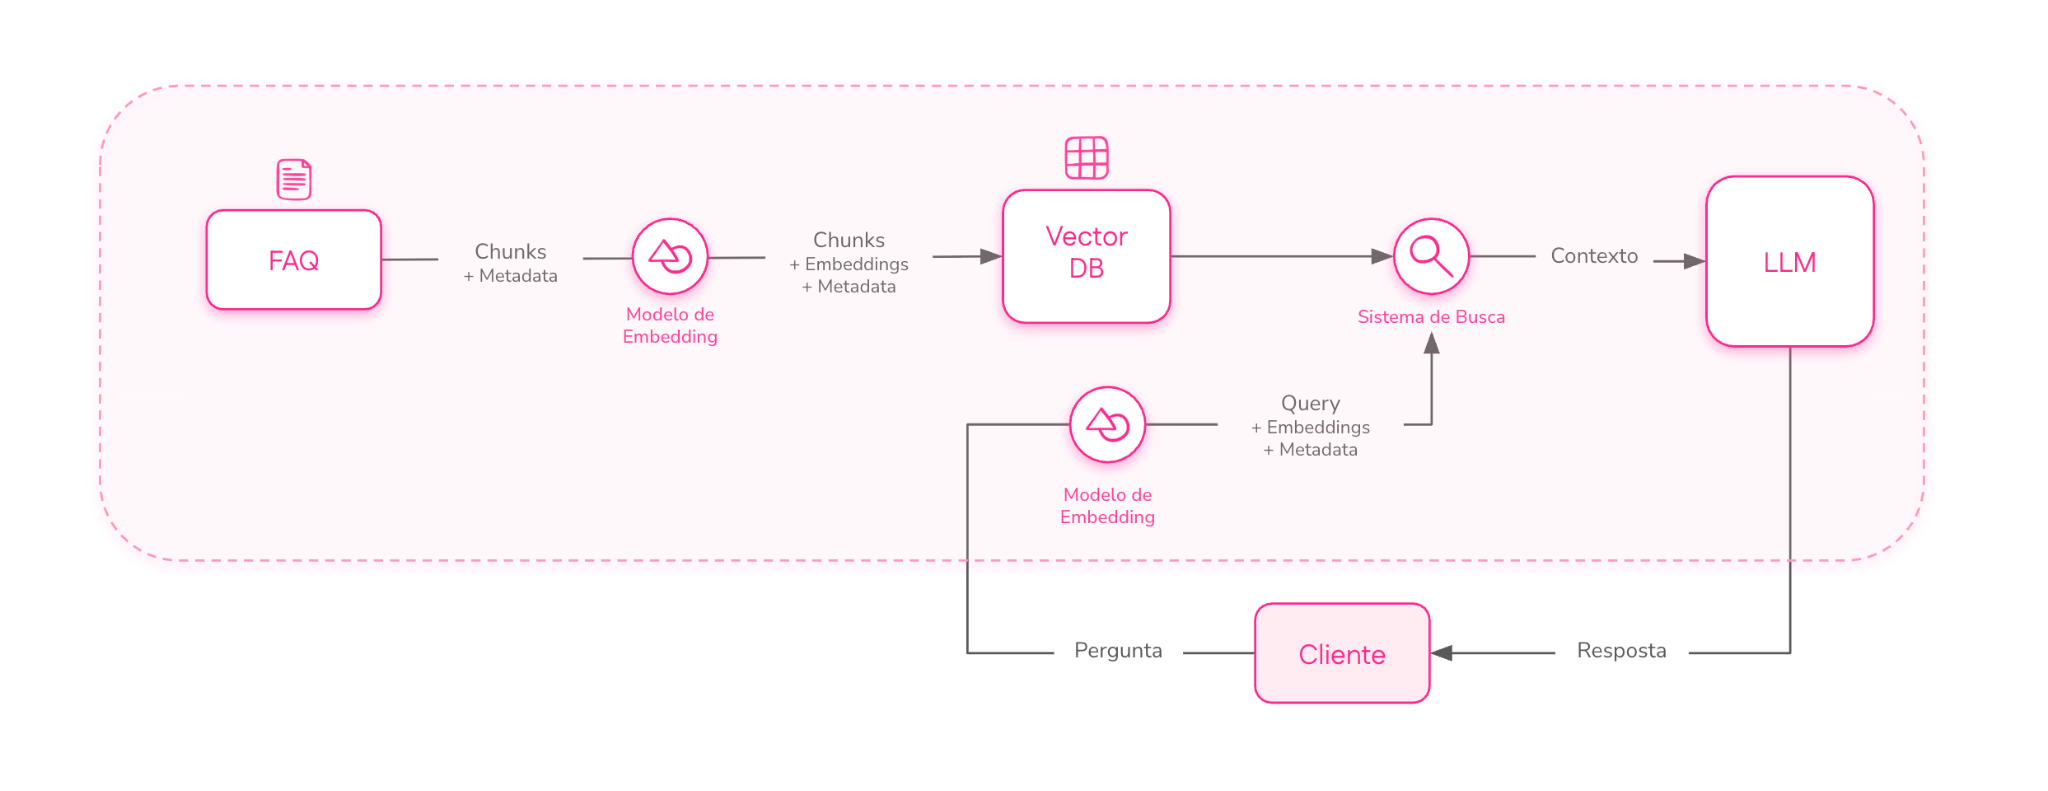
Apelidamos esse sistema de Q&A, para “pergunta e resposta” (do inglês question & answer). Uma vez que o Q&A se provasse, sabíamos que seria necessário tornar a experiência mais conversacional, porque em muitos casos a dúvida do usuário não é suficientemente bem articulada em uma única mensagem.
Definido o escopo, criamos um primeiro dataset para testes supervisionados. Esse dataset incluía (1) perguntas, extraídas dos dados históricos; (2) a referência do(s) artigo(s) da FAQ que contém a resposta; (3) uma referência de resposta. É fundamental que especialistas no domínio estejam envolvidos na avaliação de sistemas com GenAI, e portanto esse dataset foi montado em parceria com o time de CX.
Avaliando RAG
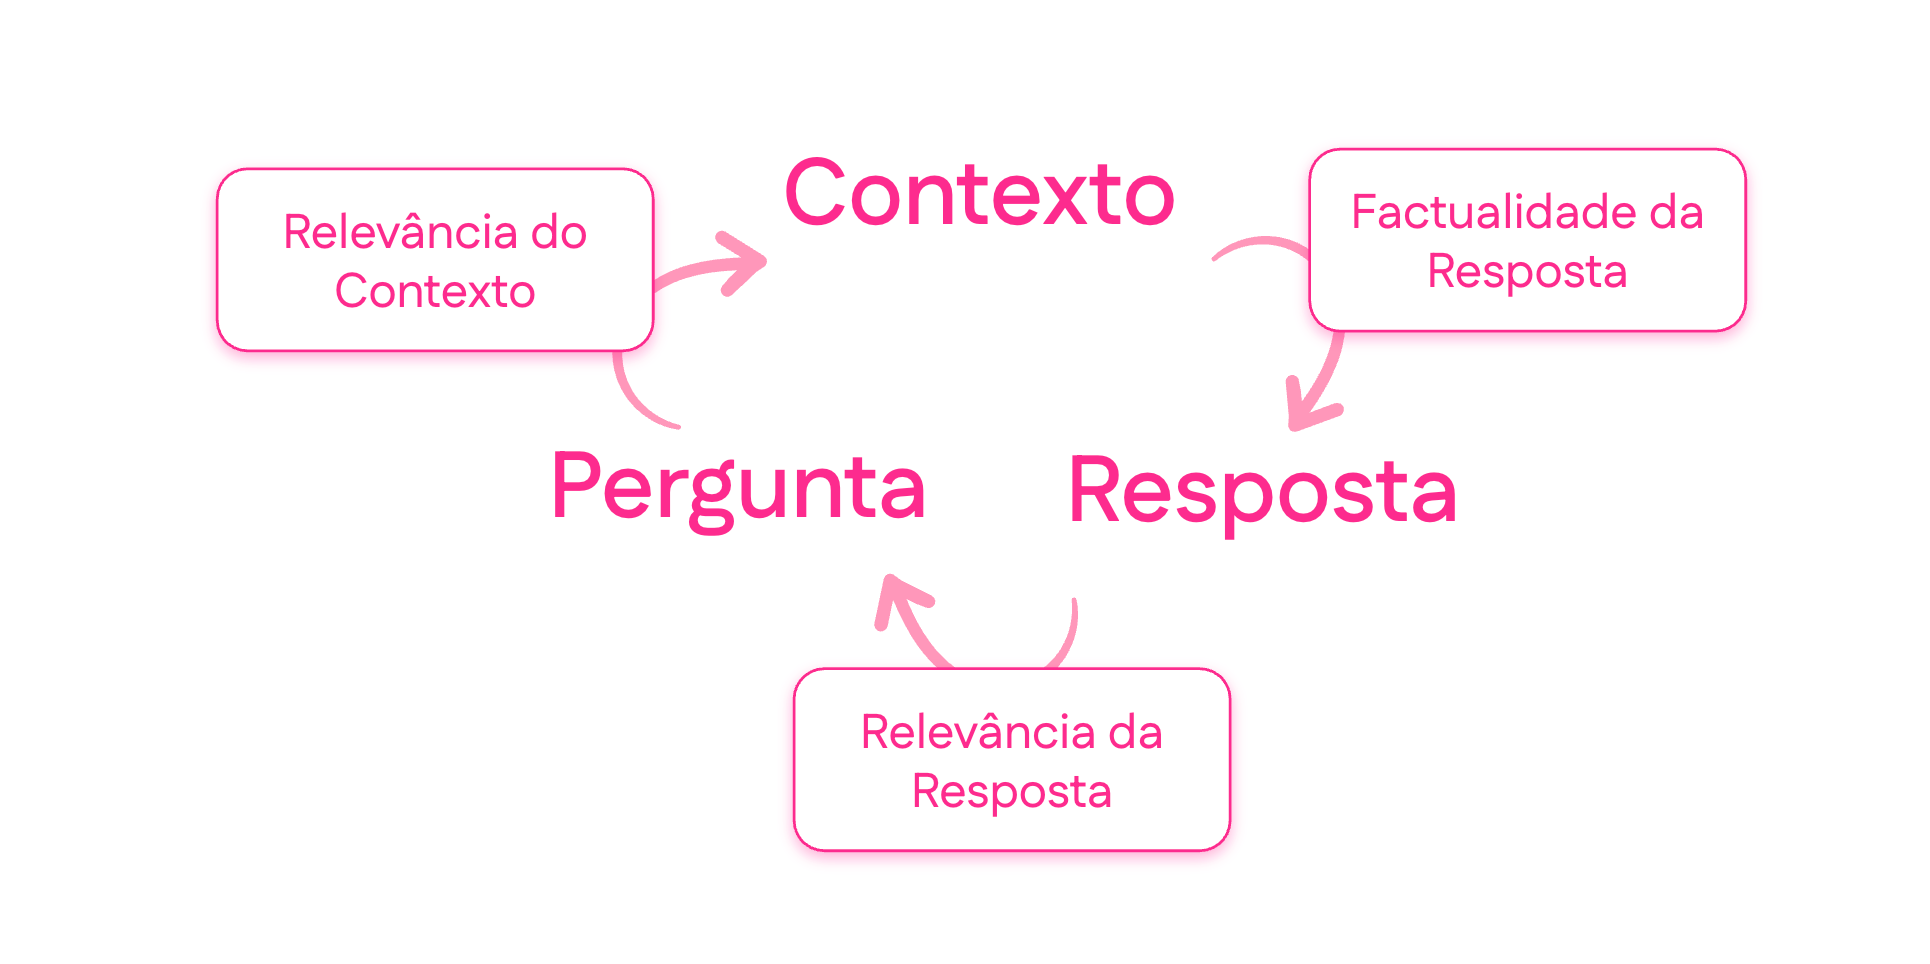
A tríade PERGUNTA x CONTEXTO x RESPOSTA define um fluxo de RAG, e portanto para avaliar o sistema é possível avaliar a interação entre cada uma de suas partes:
Ao avaliar o CONTEXTO em relação à PERGUNTA, estamos avaliando o sistema de busca isoladamente, tentando medir a relevância do contexto encontrado (”É o contexto correto para responder a pergunta?”).
Já avaliar a RESPOSTA em relação ao CONTEXTO significa quantificar a factualidade da resposta, ou seja, responder à pergunta: “A resposta é explicada pelo contexto?”. A ideia aqui é evitar o fenômeno de “alucinação”, em que modelos generativos inventam respostas não embasadas pelos contexto (às vezes com confiança impressionante!).
Já avaliar a RESPOSTA em relação à PERGUNTA, por sua vez, seria avaliar a relevância da resposta, ou seja: “A resposta responde à pergunta?”.
Para todas essas etapas, há várias maneiras de avaliar e definir métricas. Em todos os casos, é possível usar um LLM como “juíz” (LLM-judge); mas percebemos cedo que usar juízes LLM é mais complexo do que pode parecer: mais ou menos nessa época, o artigo Who Validates the Validators? Aligning LLM-Assisted Evaluation of LLM Outputs with Human Preferences [SHANKAR, Shreya et al.] revelou que usar LLM-judges cegamente é um erro, porque eles precisam ser alinhados com o julgamento de especialistas no domínio para serem confiáveis. Inclusive, o primeiro passo foi abandonar métricas baseadas em LLM-judges de prateleira, muito populares à época em frameworks como Ragas e DeepEval, que apresentavam métricas como “hallucination” e “coherence” com a promessa de avaliar o seu sistema de RAG magicamente.
Bom, basta fuçar um pouco na documentação ou no código para descobrir que várias dessas métricas não passam de um prompt escondido, em inglês, que possivelmente apresentou boa performance em algum benchmark; mas absolutamente nada garante que vai avaliar corretamente o seu sistema, no seu contexto de negócio e nos seus dados.
Dessa forma, priorizamos outras maneiras de mensurar o desempenho inicial do sistema “em bancada” (offline). Em especial, a relevância do contexto pode aproveitar métricas clássicas usadas em sistemas de recomendação e busca de informação (IR, Information Retrieval), sendo as métricas Precision, Recall, MRR e NDCG alguns exemplos.
Para usar essas métricas, basta ter um dataset com perguntas, e o contexto relevante associado a cada uma delas. Cada métrica vai avaliar a qualidade da busca de forma diferente, levando em conta a posição dos artigos relevantes no ranking gerado pelo sistema de busca. A escolha da métrica mais adequada depende do seu problema específico; no nosso caso, em que no máximo dois artigos eram relevantes para responder cada pergunta, usamos o MRR (Mean Reciprocal Rank) como métrica primária.
Também existem outras maneiras, para além de LLM-judges, de avaliar (1) factualidade e ****(2) relevância de respostas em um sistema de RAG, como por exemplo: (1) técnicas de NLI (Natural Language Inference), em que modelos pequenos são treinados para identificar se um corpo de texto é decorrente de outro; e (2) usar representações vetoriais (embeddings) da resposta gerada e de uma resposta referência, para compará-las e avaliar sua proximidade. Apesar de serem áreas interessantíssimas, à época a aplicabilidade dessas técnicas ainda era pouco madura no contexto de RAG, e parecia mais interessante colocar o sistema para rodar com usuários reais, para identificar as falhas que de fato existiam, do que passar tempo demais otimizando o sistema prematuramente.
Hora dos experimentos!
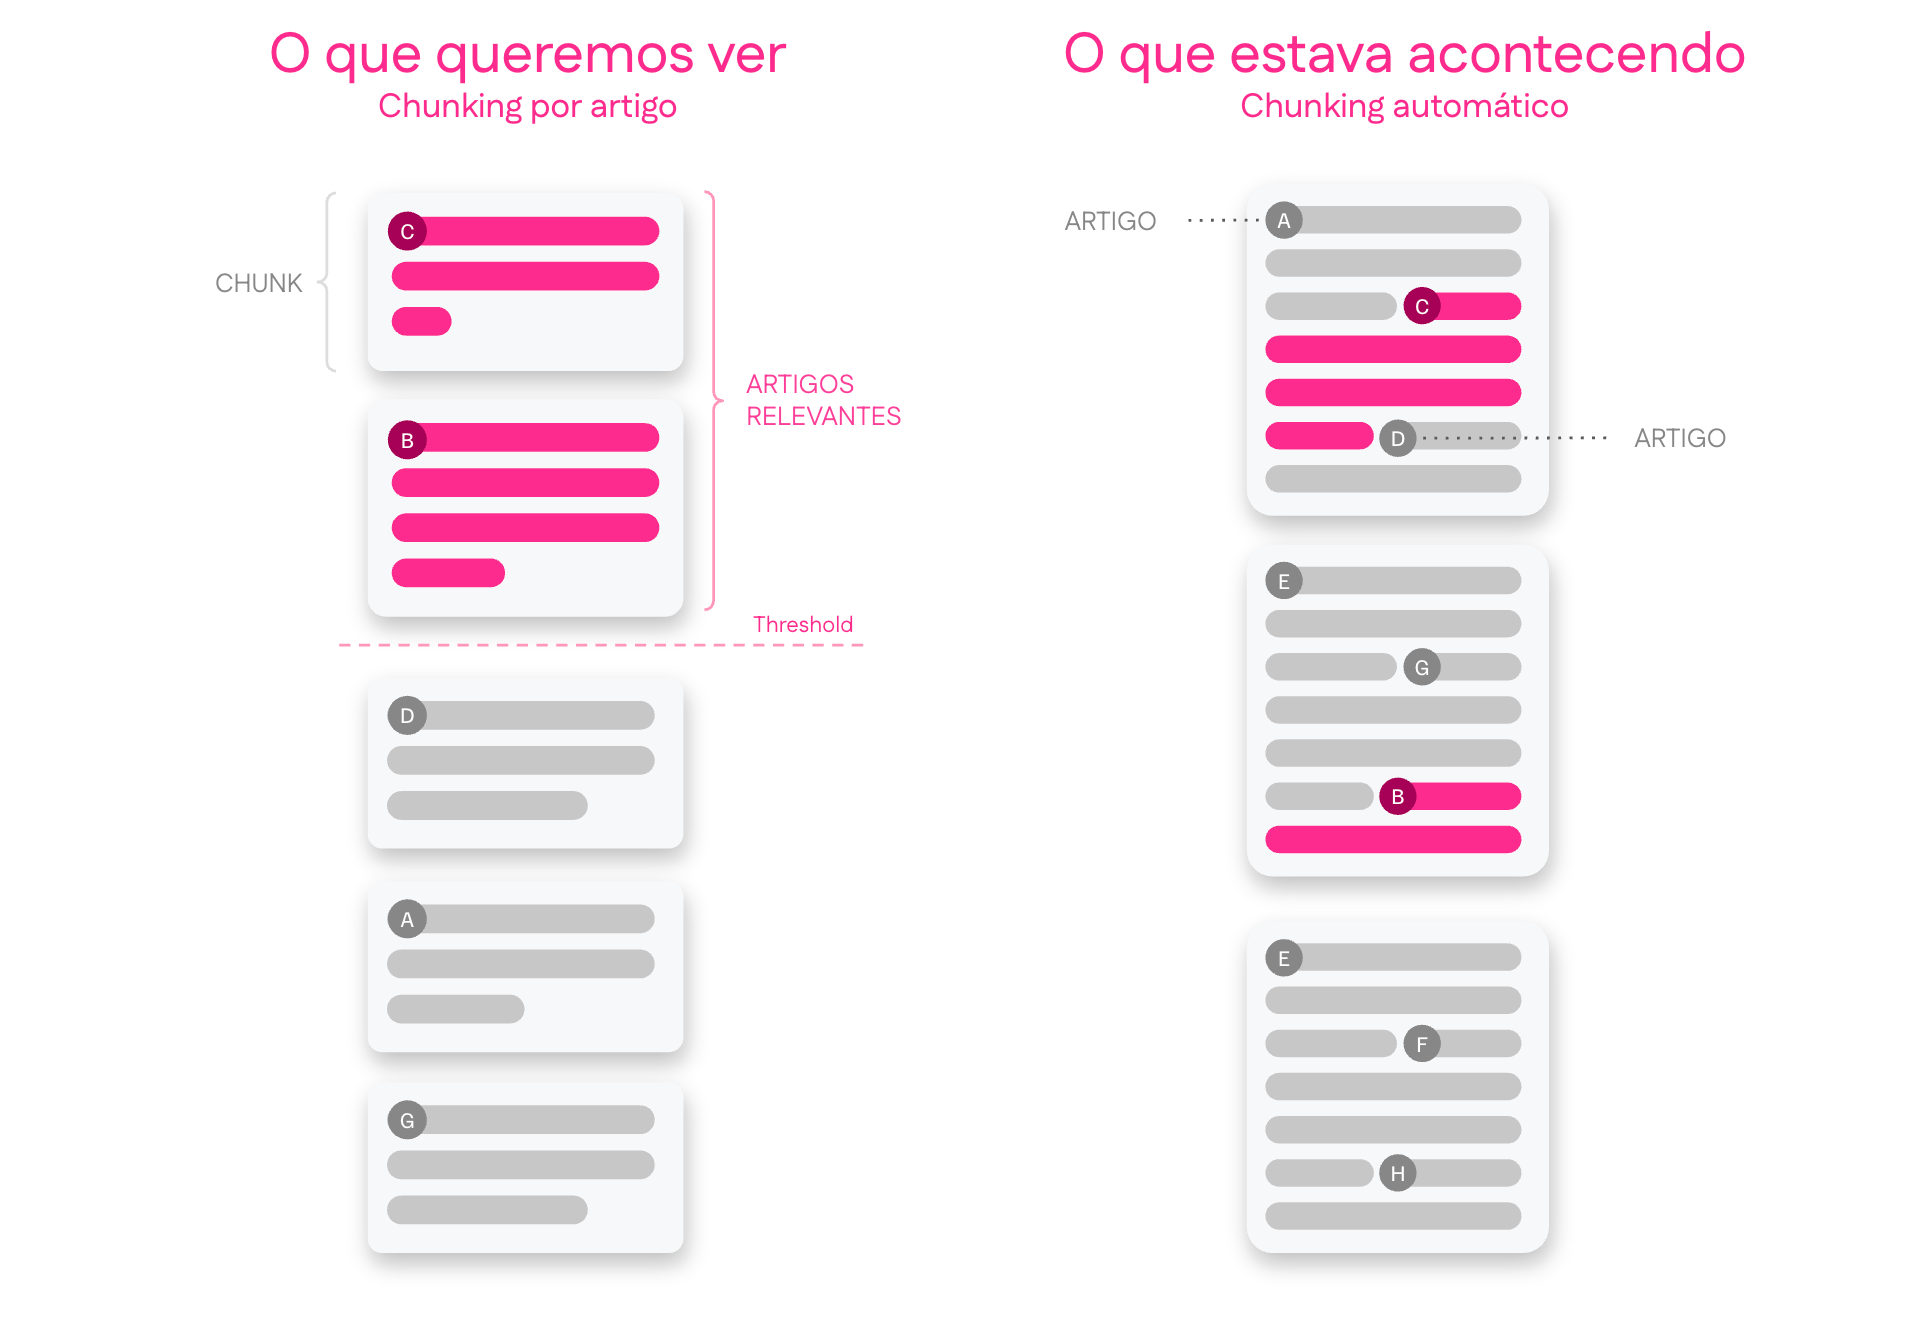
Começamos avaliando os primeiros protótipos do sistema de busca, e inspecionando os resultados preliminares. Logo de cara, percebemos que a forma como a base de conhecimento estava sendo dividida (o “chunking”, como costuma ser chamado) não fazia sentido para a nossa aplicação. Explico: se os documentos de referência são grandes, como livros inteiros, manuais de instrução ou PDFs de 200 páginas, é preciso dividir o conteúdo em fragmentos (”chunks”) mais ou menos coerentes, para que cada fragmento tenha conteúdo relevante, mas não seja grande demais a ponto de ter muitas informações misturadas. Afinal, a própria justificativa de um sistema de busca no RAG é reduzir a quantidade de informação que é passada para um modelo. Contudo, nos nosso contexto, cada artigo da FAQ é razoavelmente pequeno; era perfeitamente possível considerar cada artigo da FAQ como um fragmento na base de conhecimento, sendo guardado (junto com sua representação vetorial, ou “embedding”, e metadados) separadamente.
Conforme a janela de contexto efetiva dos LLMs aumenta, vale sempre se questionar se é de fato necessário usar um sistema de busca. Na prática, até algumas dezenas de tópicos pelo menos, pode ser mais interessante carregar o conteúdo inteiro na janela de contexto do modelo ao invés de depender de um sistema de busca. Uma etapa de retrieval começa a se justificar quando o carregamento do conteúdo completo resulta em respostas confusas ou erradas, ou em custo elevado demais.
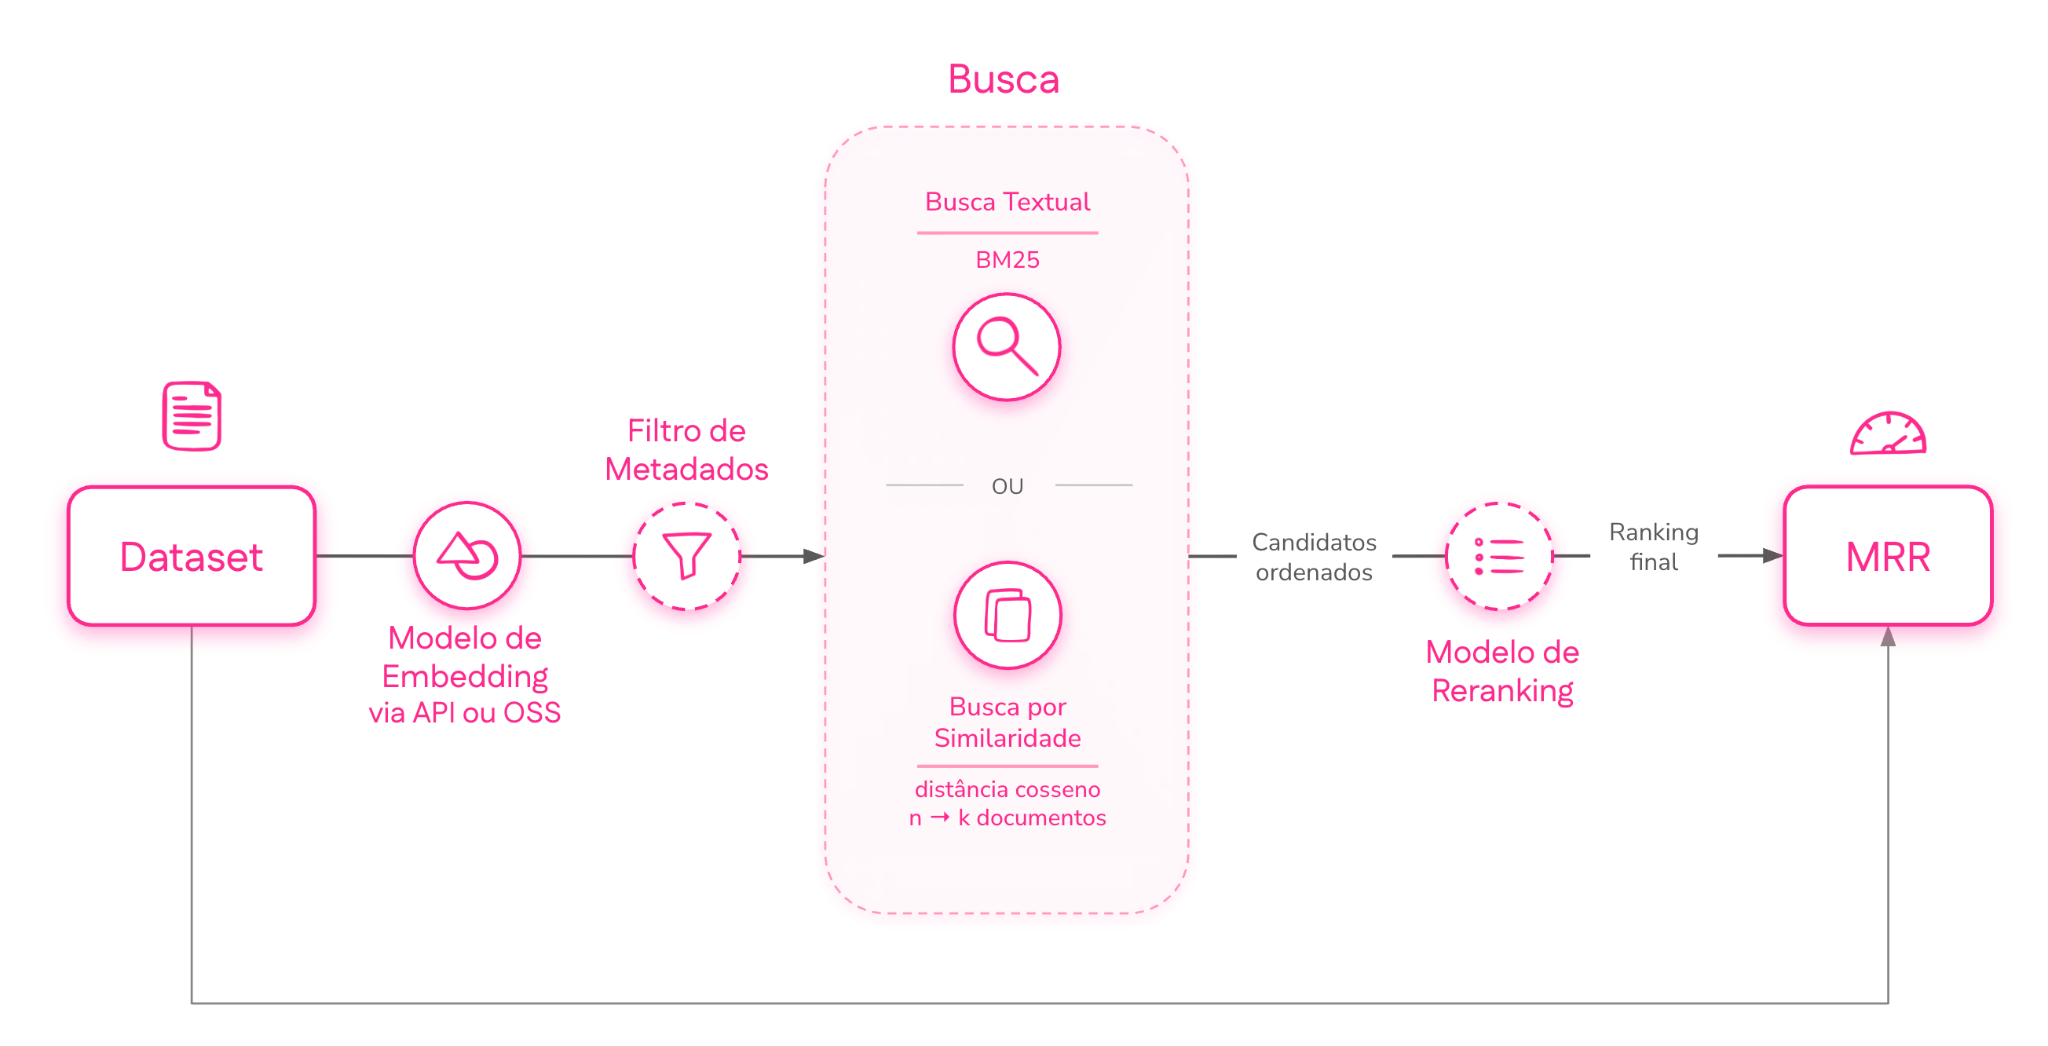
Ajustada a lógica de chunking, e com o dataset em mãos, realizamos uma série de experimentos comparando dois modelos de busca semântica (um via API e outro, open-source, rodando localmente) e o BM25 como baseline. Primeiro fizemos buscas na FAQ inteira, e depois testamos um cenário aplicando filtros de metadados. Filtrar por metadados significa reduzir o espaço de busca com informações que estarão disponíveis no momento da inferência. Na prática, nós segmentamos a FAQ entre os artigos relevantes para administradores (geralmente dos times de RH/DP dos clientes) e aqueles relevantes para colaboradores. Como o atendimento já é segmentado entre esses dois perfis, filtrar a base previamente era perfeitamente viável.
Também testamos uma etapa de reordenamento (”reranking”), em que um modelo especializado revisa a ordem dos resultados da busca inicial, buscando melhorar a ordenação final dos candidatos. Com o filtro básico de metadados e o modelo de embedding via API, conseguimos mais de 80% de MRR, o que significa que a posição do artigo relevante era, em geral, a primeira ou segunda. Com o modelo open source e o BM25, a MRR ficava mais baixa, indicando risco maior de ter o artigo desejado abaixo da terceira posição do ranking. A etapa de reranking (também via API) teve impacto relevante no modelo open source e no BM25, mas ainda abaixo do obtido sem o reranking com o modelo via API. Ou seja: o melhor compromisso entre complexidade, custo e resultado era um sistema de busca usando o modelo de embedding via API, com filtragem básica por metadados.
Saindo da bancada
Para a construção da solução final, usamos uma biblioteca para Python chamada Haystack, que, à época, era a única relevante no mercado com uma API estável (acima da v1.0.0). Outras bibliotecas como LangChain ainda mudavam recorrentemente de API, o que gerava um risco grande de manutenabilidade. O Haystack já tinha componentes prontos para os nossos requisitos do momento (conectores com o MongoDB Atlas — nossa base vetorial —, com os provedores de LLMs e modelos de embeddings usados, etc.), mas também permitiria a extensão com uma API amigável para criar novos componentes e pipelines.
Uma vez que os testes isolados do sistema de busca ficaram satisfatórios, conectamos esse fluxo de RAG em um canal do Slack. Não foi difícil achar candidatos para testar e tentar quebrar o sistema! Isso gerou dados fundamentais para a evolução do projeto, e vários ajustes foram feitos ainda nessa etapa inicial. Mais confiantes, começamos a conectar esse fluxo no nosso atendimento oficial por WhatsApp, em forma de teste A/B para alguns temas específicos. Para separar os usuários em grupos de teste e controle, usamos parte do número de telefone, de forma que a base se aproxima de uma distribuição uniforme.
Inclusive, começou ainda nos testes iniciais um ponto fundamental da plataforma de GenAI da Flash: o uso de uma ferramenta de observabilidade especializada em LLMs, o que seria muito importante não apenas para testes de bancada, mas principalmente para inspecionar as interações reais com produtos baseados em LLMs e agentes no futuro.
Feedback loop
Rapidamente, percebemos a importância de trazer os especialistas de domínio para perto, para avaliar as respostas do sistema de RAG. Adotamos a ferramenta Argilla, em modelo self-hosted integrado à Dataflash (nossa plataforma de dados). No Argilla, membros do time de CX recebiam interações de produção, e davam seu feedback em uma interface amigável.
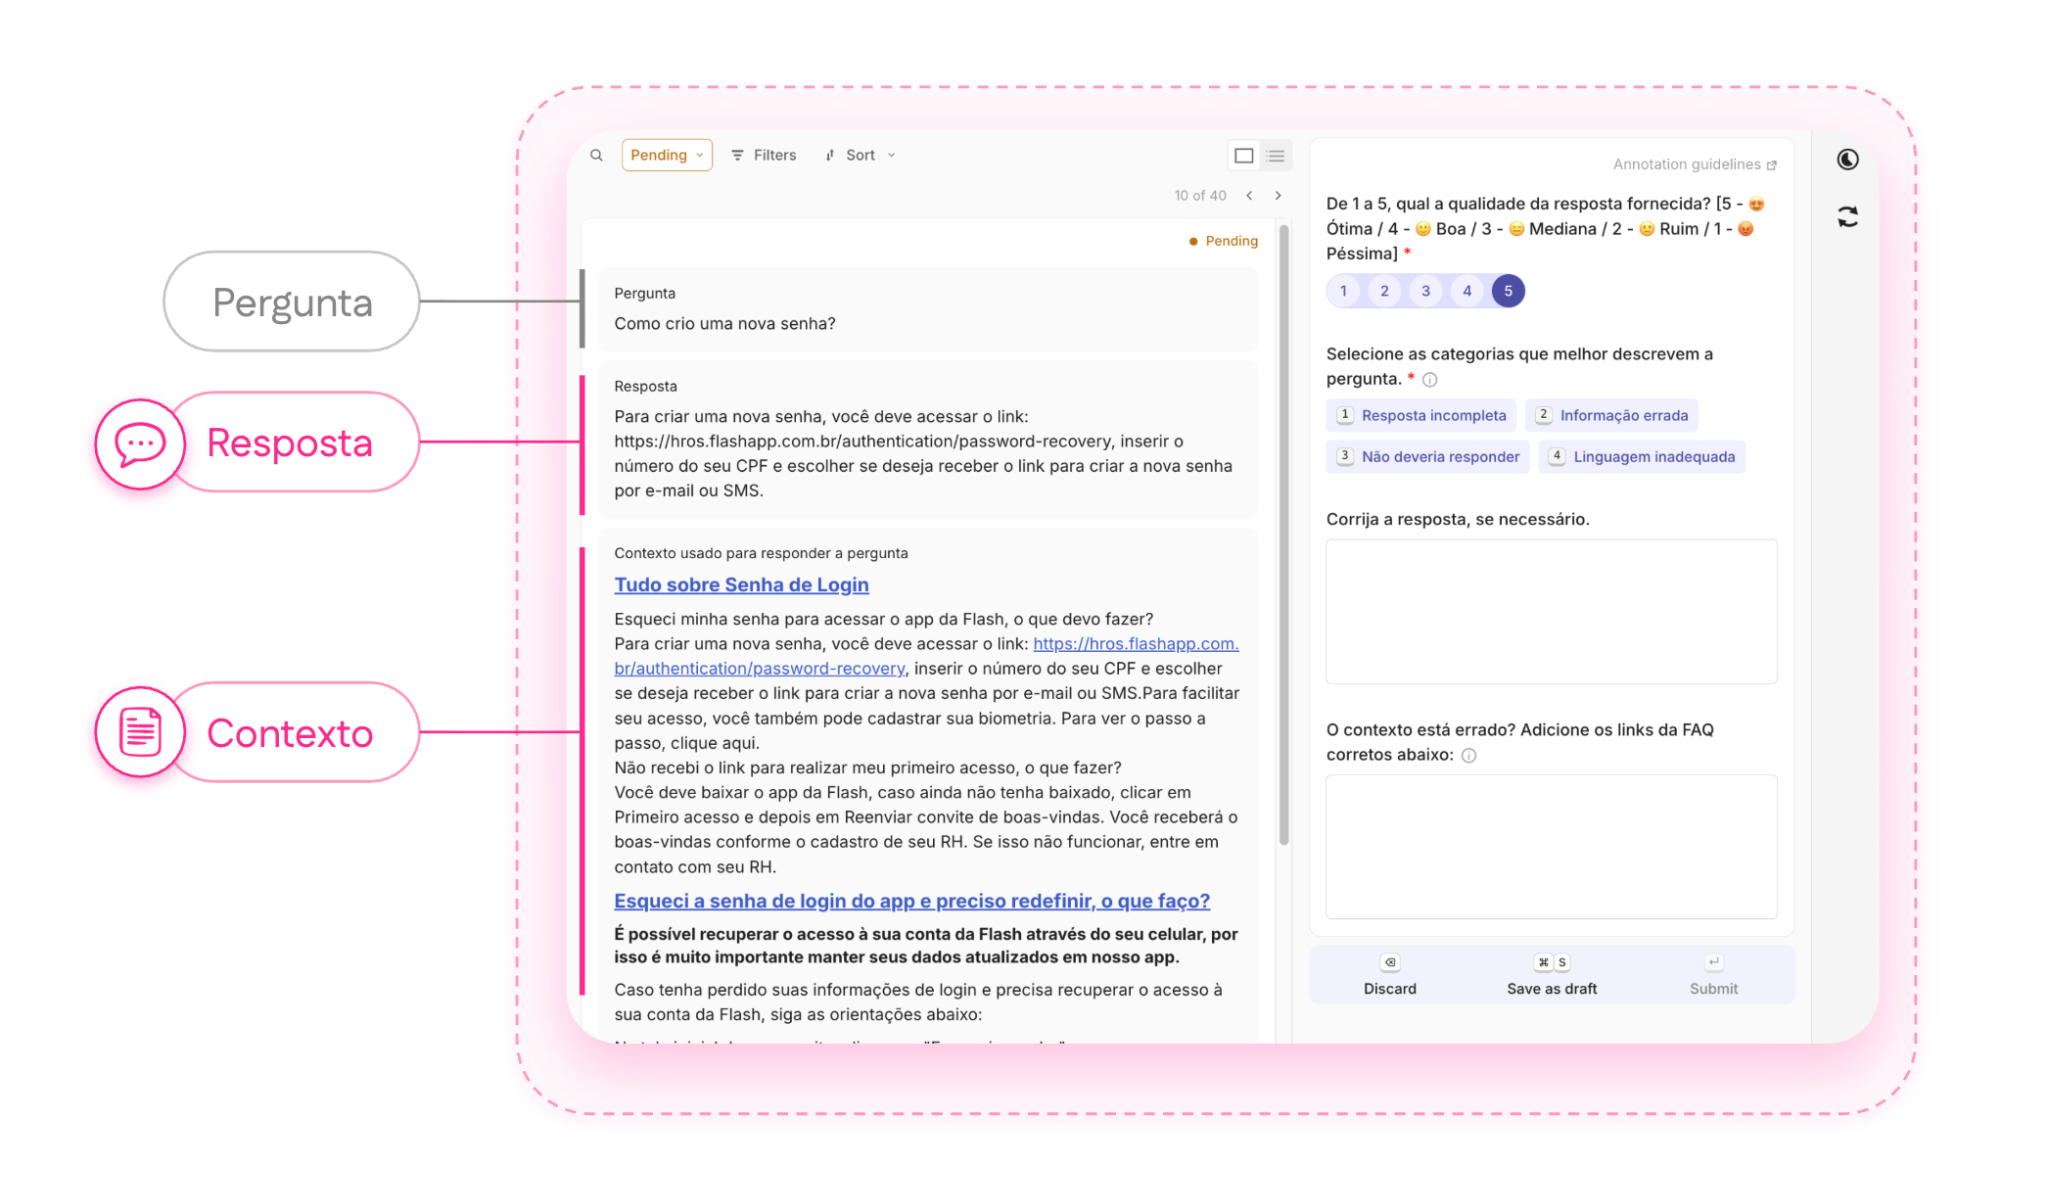
Essa foi nossa primeira configuração do Argilla. Ela mudou muito depois, quando aprendemos que avaliação binária é preferível a uma escala de 1-5 [ref], e que era preferível anotar traces e conduzir análise de modos de erro antes de assumir qualquer categorização na rubrica de anotação. Mais sobre isso no próximo artigo dessa série!
Esses dados eram consumidos novamente para a Dataflash, onde pudemos ver a evolução da taxa de aprovação, e o detalhamento dos feedbacks dados. Rapidamente, aprendemos uma grande virtude do projeto consumir as FAQs oficiais da Flash, e de fecharmos o ciclo de feedback: o próprio time de CX percebia a necessidade de rever ou adicionar artigos à FAQ, inspecionando interações em que o Q&A não soube responder alguma dúvida.
Primeiros resultados e o conversacional
À época da primeira implementação do Q&A, o incremento em retenção foi de mais de 14 p.p. em relação à baseline sem GenAI. Foi um resultado muito positivo, mas sabíamos que o impacto real ainda estava por vir.
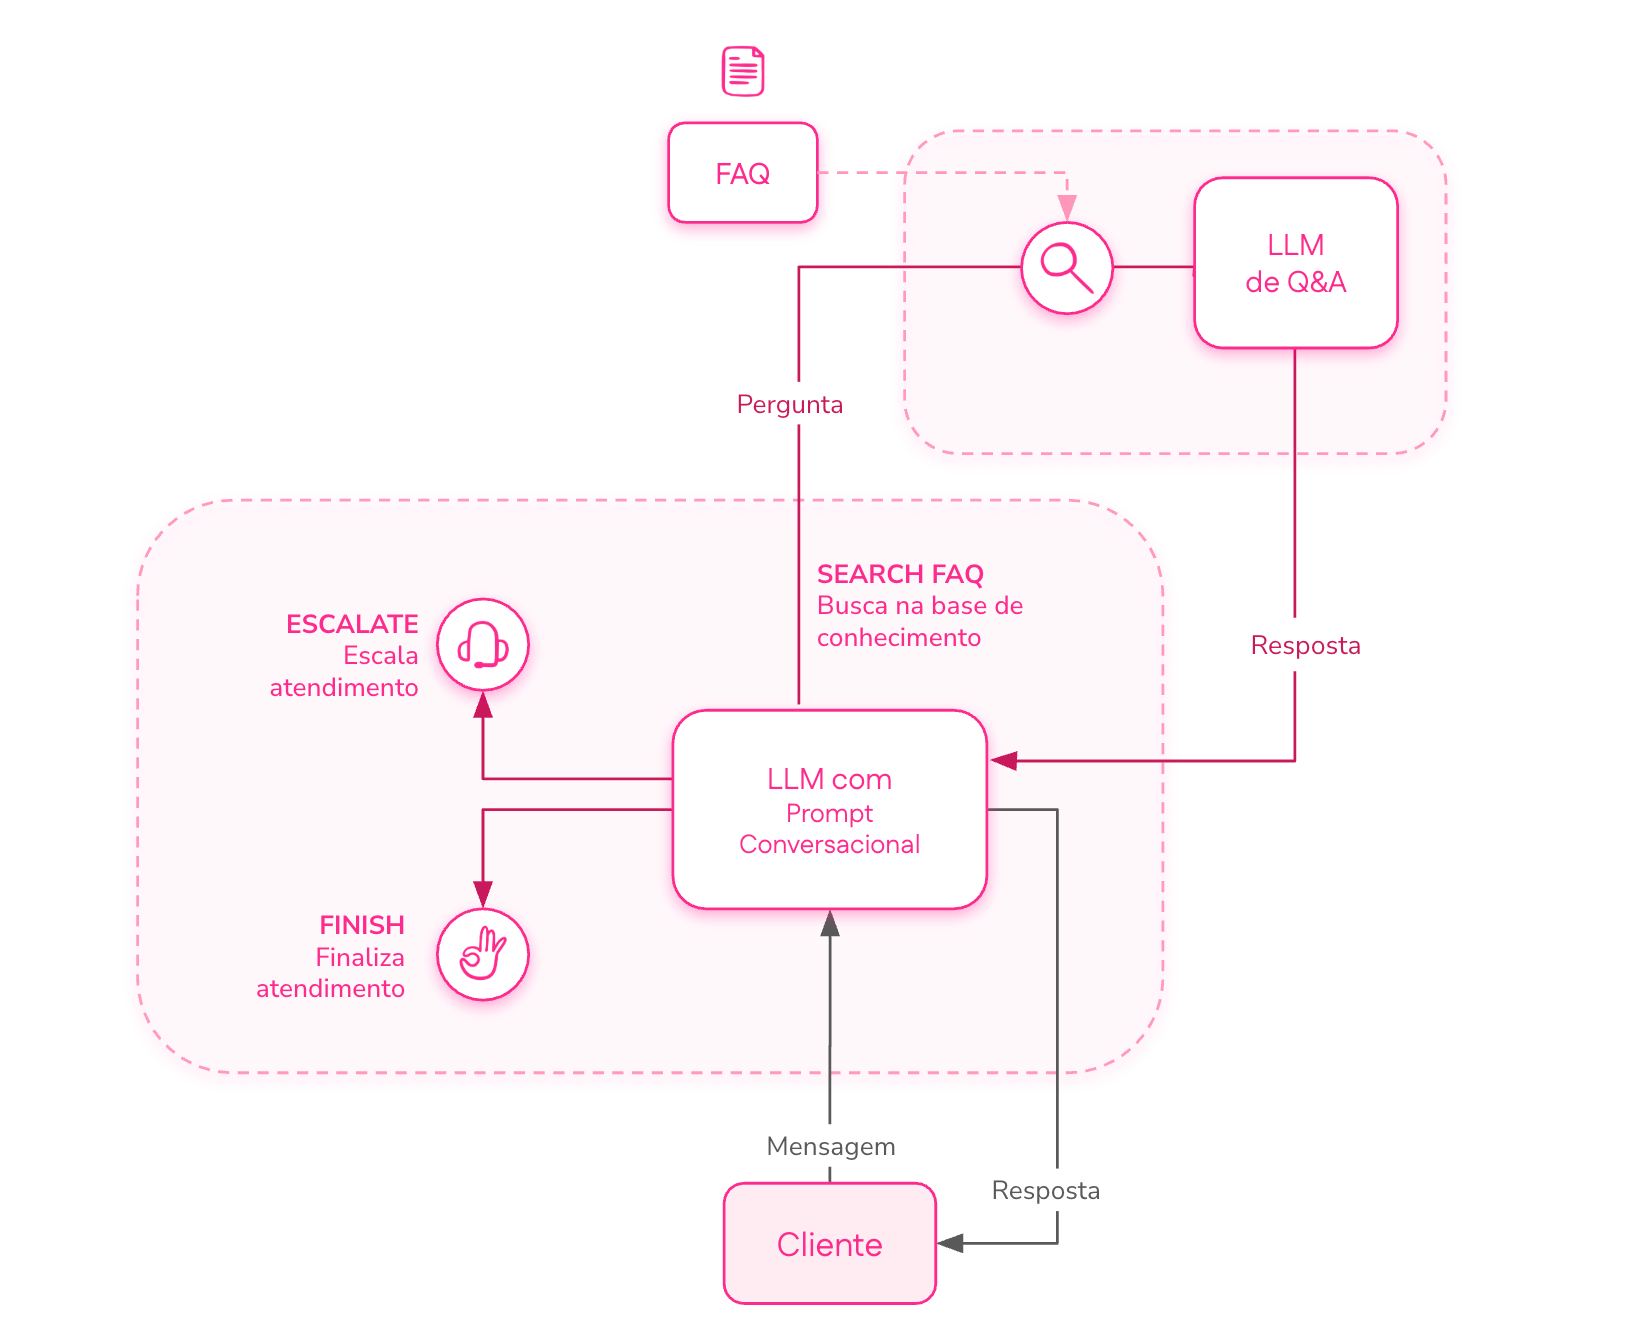
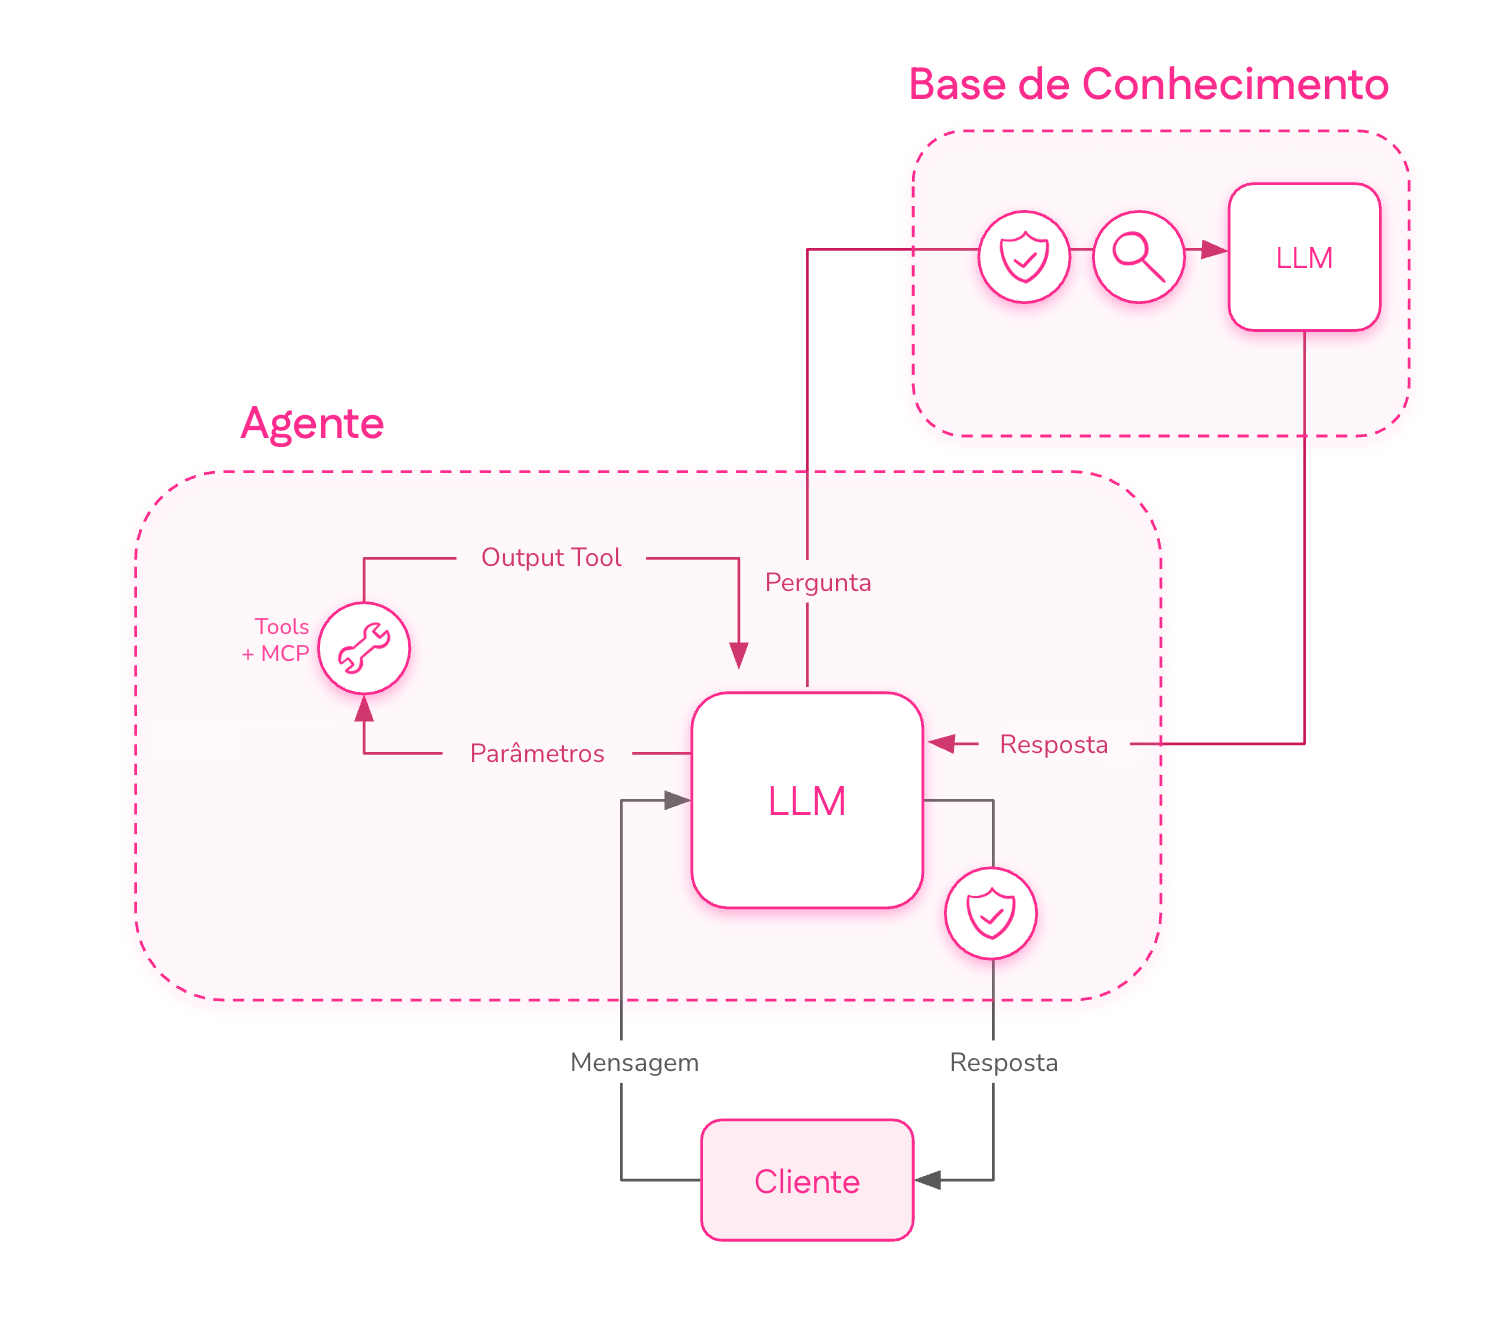
O próximo passo evidente era um fluxo conversacional, que permitiria aos colaboradores elaborar melhor a sua dúvida ou problema. Criamos então, ainda usando Haystack, um loop agêntico simples com acesso a ferramentas (o chamado “ReAct agent”). Dotado de um prompt de sistema fixo, o agente decide a cada passo se deseja usar uma ferramenta à sua disposição, consultar uma base de conhecimento, ou responder o usuário.
Esse agente tinha, desde o início, apenas três ferramentas: escalate, para indicar o transbordo, depois do qual o atendimento seria passado para um atendente humano; finish, indicando o “caminho feliz” do atendimento, em que o cliente teve sua dúvida sanada; e search_faq, que permite consultar a FAQ de atendimento – na prática chamando a API do Q&A. Como os processos de feedback e o sistema de RAG já estavam maduros, implementar esse agente foi muito mais rápido, e em poucos meses passamos de 5% a 50% do fluxo sendo impactado pelo agente, chegando a um incremento de 40 p.p. na retenção do pré-atendimento quando comparada à baseline sem GenAI!
Da prova de conceito à plataforma
Esse projeto inaugurou a construção dos primeiros objetos de plataforma para GenAI:
- Uma base de conhecimento, com um LLM acoplado para responder dúvidas, construída em Haystack e disponibilizada para a empresa como um objeto interno acessível via API. Esse objeto evoluiu com o tempo, e hoje aceita fontes variadas como planilhas do Drive, PDFs, documentação interna, e qualquer dataset dentro do nosso ambiente analítico — permitindo, na prática, criar bases de conhecimento prontas para serem consumidas por agentes, a partir de qualquer fonte de dados ingerida na Dataflash.
- Um agente self-serve, que se integra nativamente com as bases de conhecimento internas, funções customizadas e servidores MCP selecionados. Qualquer flamingo (como chamamos os colaboradores aqui na Flash) pode criar um agente definindo seu prompt de sistema e as ferramentas às quais tem acesso!
Aprendizados
Compartilho abaixo algumas lições aprendidas ao longo dessa primeira etapa do projeto:
- Coloque seu sistema na frente de usuários, mesmo que internamente, o quanto antes. Vale a pena testar algumas coisas em bancada, mas nada substitui a interação com usuários reais. Isso é verdade com software no geral, mas com sistemas baseados em LLMs, em que o resultado pode variar muito, é ainda mais importante.
- Quando fizer sentido, transformar uma entrega individual em um objeto plataformizado pode ampliar o impacto de uma solução, dando acesso a outros times, aplicações e contextos de negócio.
- Olhe para os dados antes de tudo! A inspeção de traces (registros de interação) é a pedra fundamental de avaliação de sistemas com GenAI. Falaremos mais disso em artigos futuros ;)
- Mesmo um fluxo de RAG supostamente simples precisa de muitos skillsets para sair do papel de forma séria e sólida: data analytics, plataforma de dados, ciência de dados, produto, estratégia, CX e negócio estiveram presentes desde o início!
- Dividir o problema foi fundamental. Focar no fluxo Q&A antes de fazer a experiência conversacional foi muito importante para o amadurecimento dos processos e de todos os times envolvidos, o que permitiu uma evolução muito mais sólida para as fases seguintes.